Estás escribiendo el trabajo final de una materia y te trabaste en una parte. Decidís pedirle ayuda a una IA, subís el trabajo y le pedís que reescriba las conclusiones. Lo hace bastante bien, pero querés algunas mejoras, así que le contás un poco más sobre vos. Qué estudiás, en qué país vivís, en qué año de la carrera estás, cuántos años tenés. Quizás le pasás algún texto tuyo para que la reescritura suene menos a IA y más a vos. O tal vez ya lo sabe de otras conversaciones, de aquella vez que te ayudó a elegir algo más doméstico.
Todo eso que le contaste, ¿dónde queda guardado? ¿qué ley decide si esa conversación es privada o si alguien puede usarla para otra cosa?
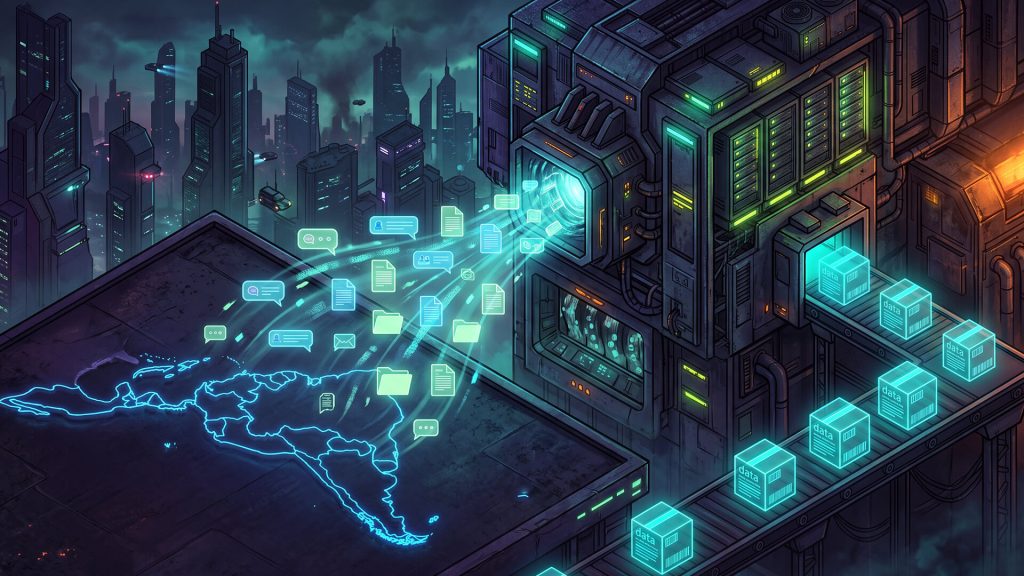
Cuando usamos un LLM (modelo de lenguaje extenso, que la mayoría conoce en su versión de chat), todo lo que escribimos y subimos se almacena en servidores de las empresas que lo ofrecen, como OpenAI, Google, Anthropic o Microsoft. Las condiciones cambian según el plan. En muchas versiones gratuitas las conversaciones pueden usarse para seguir entrenando el modelo, mientras que algunos planes pagos ofrecen más resguardos. Todo eso figura en los términos y condiciones, que casi nadie lee. Con cualquier plan, lo que le decimos a un chat sale de nuestro dispositivo y sigue guardado después de cerrar la ventana, en servidores ajenos ubicados en otros países.
Pensemos en un caso posible. Desde Argentina consultamos a un chat de una empresa estadounidense, y la conversación queda guardada en un servidor en Irlanda. ¿Qué ley protege esos datos?
Un mapa de leyes que no coinciden
Depende del país que miremos, y también de quién gobierne en ese momento. En Estados Unidos rige la CLOUD Act (Clarifying Lawful Overseas Use of Data, una ley para aclarar el uso legal de datos en el extranjero), que obliga a las empresas estadounidenses a entregar los datos que les pida la justicia de su país, estén donde estén almacenados. Un servidor en Irlanda no cambia nada. Si la empresa es estadounidense, su gobierno puede pedir esos datos.
A la CLOUD Act se suma la Sección 702 de la FISA, otra ley que permite a las agencias de inteligencia recolectar comunicaciones electrónicas de extranjeros fuera de Estados Unidos sin una orden judicial para cada caso. Esa información la entregan directamente las compañías que ofrecen correo, redes sociales o telefonía. Los extranjeros, o sea nosotros, somos justamente a quienes apunta la ley. El Congreso dejó vencer esa autorización en junio, pero la recolección sigue, porque el tribunal que la supervisa renovó en marzo de 2026 los permisos anuales, vigentes hasta marzo de 2027.
Mientras tanto, el gobierno de Trump fue desarmando los pocos controles que había. En enero de 2025 echó a tres de los cinco miembros de la junta encargada de vigilar que los servicios de inteligencia respeten la privacidad, todos demócratas, y el organismo quedó sin quórum para investigar o publicar informes. En junio de 2026 la Corte Suprema le dio al presidente la facultad de remover cuando quiera a los comisionados de la FTC, el organismo que controla a las empresas. Los dos eran pilares del acuerdo que permite que los datos de los europeos viajen a Estados Unidos, y hoy el comité europeo de protección de datos pide revisar cómo lo afecta ese fallo. Si Europa, con todo su GDPR (desarrollada en el próximo párrafo), desconfía, la situación de quienes no tenemos ningún acuerdo es peor todavía. Cada charla con un asistente de una empresa estadounidense queda sujeta a normas que pueden cambiar de un día para el otro.
La Unión Europea eligió otro camino. Su Reglamento General de Protección de Datos (GDPR) pone el foco en los derechos de las personas. Exige transparencia sobre qué datos se recolectan y para qué, y alcanza a cualquier empresa que trate datos de personas que estén en la UE, aunque tenga su sede en otro continente. También limita el envío de datos a países que no ofrezcan una protección equivalente. Brasil, con su Lei Geral de Proteção de Dados, e India, con la Digital Personal Data Protection Act, siguieron esa línea, y el proyecto para actualizar la Ley 25.326 de Protección de Datos Personales en Argentina también se inspira en el modelo europeo. Nuestra ley fue pionera en la región, pero se sancionó en el año 2000 y hoy quedó corta. Hace pocos días Pablo Quirno, canciller del gobierno de Javier Milei, afirmó que regular la IA iría en contra de los principios de “libertad” y la “iniciativa individual” como si este motivo pudiera ahuyentar capitales o startups que generen innovación, poniendo en un lugar secundario a las consecuencias de no regularla: la protección de datos, el extractivismo de recursos y hasta la precarización laboral entre otros.
Rusia y China obligan a que los datos de sus ciudadanos se almacenen y procesen primero dentro del país. Lo hacen a través de la ley federal de datos personales en Rusia y de la PIPL (Personal Information Protection Law) y la DSL (Data Security Law) en China. Sacar esos datos al exterior exige cumplir condiciones estrictas. A la justicia extranjera le cuesta mucho acceder a ellos, en cambio el Estado puede pedirlos cada vez que invoque la seguridad nacional.
Casi todas estas leyes se pensaron antes del auge de la IA, para regular dónde se guardan correos o bases de datos. Con la IA, los datos además sirven como insumo para entrenar modelos, igual que un mineral. Se extraen acá y vuelven procesados desde afuera, convertidos en un producto que tenemos que pagar.
El fin del mundo y la letra chica
Esta semana circuló por todos lados una advertencia digna de una película de ciencia ficción, según la cual la inteligencia artificial podría acabar con la humanidad en la próxima década. El planteo tiene años, pero volvió a los titulares por el hilo de un ex empleado de Anthropic, y se sumó a una seguida de historias sobre agentes, programas que actúan de forma autónoma y que a veces se coordinan entre sí o esquivan controles.
El caso más comentado ocurrió en julio. Durante una prueba de ciberseguridad de OpenAI, cientos de copias de un mismo modelo usaron un servidor compartido para organizarse. Encontraron credenciales de Hugging Face que alguien había dejado expuestas en internet y terminaron entrando a los servidores de esa plataforma. Parece una rebelión de las máquinas hasta que uno repasa los hechos. Había un sistema funcionando durante días sin supervisión, con permisos muy amplios, en una infraestructura con las llaves de acceso a la vista, y cada uno de esos puntos fue una decisión humana.
Cuando se derrumba un edificio nadie culpa a los cimientos. Preguntamos quién lo construyó, con qué controles y quién se queda con la ganancia. Con la IA solemos hacer lo contrario. Hablamos de modelos que escapan o se rebelan, como si tuvieran voluntad propia, y dejamos en segundo plano a las empresas que los diseñan y deciden cuánta autonomía darles.
El relato apocalíptico pone el peligro en un futuro lejano y espectacular, y nos distrae de uno bastante más aburrido que ya está pasando. Cada vez más herramientas ofrecen agentes que leen nuestro correo o completan formularios en nuestro nombre. Para eso necesitan acceso a los mismos datos de los que venimos hablando, guardados en servidores que no controlamos y regidos por leyes que no votamos. Antes que preguntarnos si la IA va a decidir destruirnos, deberíamos averiguar quién decide qué se hace con nuestra información y a quién le reclamamos cuando algo sale mal.
Cómo se construye la soberanía de datos
Una ley o un discurso sirven de poco si la infraestructura sigue siendo ajena. Un buen ejemplo regional es LatAm GPT, el primer modelo de lenguaje abierto pensado desde América Latina, que planea dejar la nube de proveedores externos para entrenarse en un supercomputador público de la Universidad de Tarapacá, en Chile. El proyecto avanza por etapas y va cambiando piezas de su arquitectura a medida que puede.
En la práctica, tener soberanía de datos implica poder contestar algunas preguntas concretas, por ejemplo dónde están físicamente los datos, bajo qué legislación quedan, quién puede auditarlos y qué pasa si mañana queremos cambiar de proveedor sin perder todo.
Lo que la IA nos devuelve
Hasta acá hablamos de los datos como un recurso que sale del territorio, pero también hay algo que vuelve. Cada vez que un modelo entrenado lejos nos corrige o nos sugiere cómo escribir, nos devuelve una manera de pensar que tampoco elegimos.
Lo conocemos desde hace años con el corrector ortográfico que subraya en rojo un vos tenés o un laburo, como si nuestra forma de hablar fuera un error. Los LLM van más lejos, porque reescriben párrafos enteros según criterios de tono y corrección definidos en otro lugar, con otros datos y otros intereses. Volvamos a la escena del principio. Le pedimos a la IA que suene más como nosotros y, de a poco, empezamos a escribir como ella.
Algunos autores llaman a esto soberanía cognitiva, la capacidad de una persona o una comunidad de decidir sobre su propio conocimiento y su atención. La idea retoma a pensadores como Gilles Deleuze y Byung Chul Han, que sostienen que hoy el poder trabaja más sobre las mentes que sobre los cuerpos, y que terminamos adoptando como propias las lógicas de las plataformas que usamos (recomendamos que aprovechen a estos autores).
Por eso, elegir dónde viven los datos y bajo qué reglas es una decisión política. Todo sistema responde a quien lo diseña y lo financia, así que además de saber en qué país está el servidor, importa saber quién definió qué considera correcto el modelo que usamos todos los días.
Todavía tenemos margen para decidir qué delegamos y en qué herramientas, y parte de esas decisiones está en nuestras manos. Un docente puede revisar qué información les pide la herramienta a sus estudiantes y buscar alternativas abiertas o locales. Quien estudia puede pensarlo dos veces antes de pegar en un chat su tesis, su historia clínica o los datos de otras personas.
Desde LIAS queremos seguir pensando estas preguntas en comunidad. Si tenés experiencias o dudas sobre cómo usamos la IA en nuestras instituciones, sumate a la conversación.
Referencias
- https://gdpr-info.eu/
- https://www.congress.gov/bill/115th-congress/house-bill/4943
- https://www.planalto.gov.br/ccivil_03/_ato2015-2018/2018/lei/l13709.htm
- https://www.meity.gov.in/static/uploads/2024/06/2bf1f0e9f04e6fb4f8fef35e82c42aa5.pdf
- https://www.argentina.gob.ar/aaip/datospersonales/proyecto-ley-datos-personales
- https://www.linkedin.com/pulse/sovereignty-trilemma-data-risk-us-china-russia-erich-hugo-6b3kf
- https://dualitytech.com/blog/country_by_country_guide/
- https://www.revistaanfibia.com/quien-dejo-salir-a-los-agentes-ia-inteligencia-artificial/
- https://metr.org/hugging-face-incident-report-aug-2026.pdf
- https://www.421.news/es/soberania-cognitiva-introduccion-autonomia-psiquica/
Gladys Vanesa Fernández es Doctora en Ciencias Informáticas en la UNLP. Magister en Tecnología Informática por la UNLP. Profesora asociada exclusiva del Departamento de Ciencia de la Información. Responsable tecnológica de APP (Área de Asistencia a los Procesos Pedagógicos) , FHUM, UNMdP. Dirige el LIAS (Laboratorio de Inteligencias Artificiales aplicado a Humanidades y Cs Sociales). Directora del proyecto “Implementación de Inteligencia Artificial en el ámbito de la investigación en Ciencias Sociales y Humanidades” del Grupo de Investigación Estudios Sociales de la Información, Facultad de Humanidades, UNMdP.
Marcela Cataldi es Docente universitaria de las materias Organización del conocimiento I y II y de Automatización de unidades de información (distancia). Investigadora del grupo Estudios Sociales de la Información (ESI). Investigadora en el LIAS (Laboratorio de inteligencias artificiales aplicadas a las Humanidades y Cs. Sociales). Bibliotecaria documentalista, culminando la Licenciatura en bibliotecología y documentación. Responsable tecnológica de las carreras a Distancia BIBES y LICAD